作者:刘新海
对于传统信用数据,风控建模技术比较成熟,但是对于大数据,风控模型该怎么做?为什么数据越来越多,信用评价却不一定变得更容易?这是我研究《征信与大数据》时的动机,也是此后多年研究个人数据管理的起点。
互联网金融时代,新的信贷客户,需要新的信用信息
传统征信主要围绕信贷交易及相关信息展开。经过长期发展,金融机构、征信机构之间形成了相对成熟的数据报送、信用报告、查询使用和风险建模机制。对于有较充分信贷记录的人,这套体系能够提供重要的风险判断依据。
但信贷市场在变化。互联网金融、网络借贷及其他新产品接触到越来越多此前很少使用银行信贷服务的人。一个人缺少信贷记录,意味着金融机构掌握的信息不足,并不意味着这个人一定缺乏还款能力。如何评价这些客户,成为信贷业务发展的现实问题。世界银行也将缺少或只有少量传统信用记录的客户,视为替代数据可能发挥作用的重要群体。我国的个人征信系统建设只有20年的历史,还没有实现对个人信用主体的信用记录全覆盖。
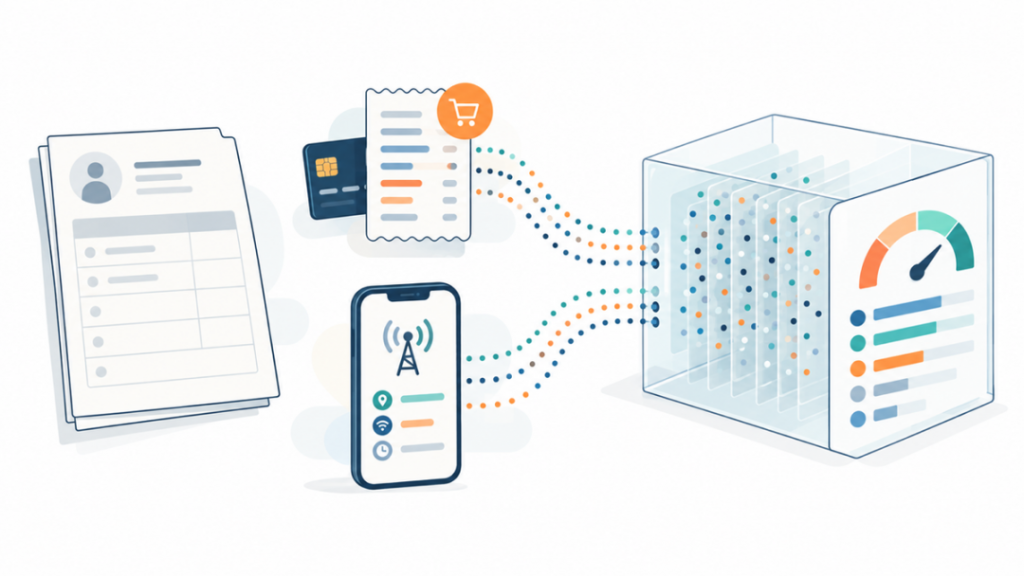
移动互联网的发展恰好提供了新的数据来源。支付流水、电信使用及其他数字服务数据,可能反映个人的经济活动与行为特征。于是,一个很有吸引力的设想出现了:能否利用这些数据,帮助金融机构识别传统征信覆盖不足的客户?这就是当年“大数据征信”研究的重要背景。
数据多了,模型反而更难建
我写《征信与大数据》,最初关注的正是建模问题。
传统信贷数据与信用风险之间有比较清晰的业务关系。例如,已有借款、还款和逾期记录,本身就直接反映了过去的信用行为。但电信等数据与还款风险之间的关系没有这么直接。一份数据可能包含大量维度,变量看似丰富,却未必具有稳定的预测能力。
因此,大数据征信不能停留在“数据越多,评分越准”的想象中。研究者至少要回答几个问题:哪些特征确实与未来还款表现有关?这种关系能否在不同人群、不同时间得到验证?模型为何作出某种判断?是否会因看似无关的行为数据而造成不合理的差别对待?
这些问题让我意识到,建立一个成熟的信用评价模型,远比把大量数据输入算法复杂。信用评价模型既要有效,也要稳定、可解释,并能够接受业务和监管检验。世界银行关于替代数据和数字信贷的研究,同样关注数据质量、模型解释及消费者保护。
模型之外,还有一道更难的关
随着研究深入,以及与大数据企业开展合作,我又遇到一个更基础的问题:数据从哪里来?
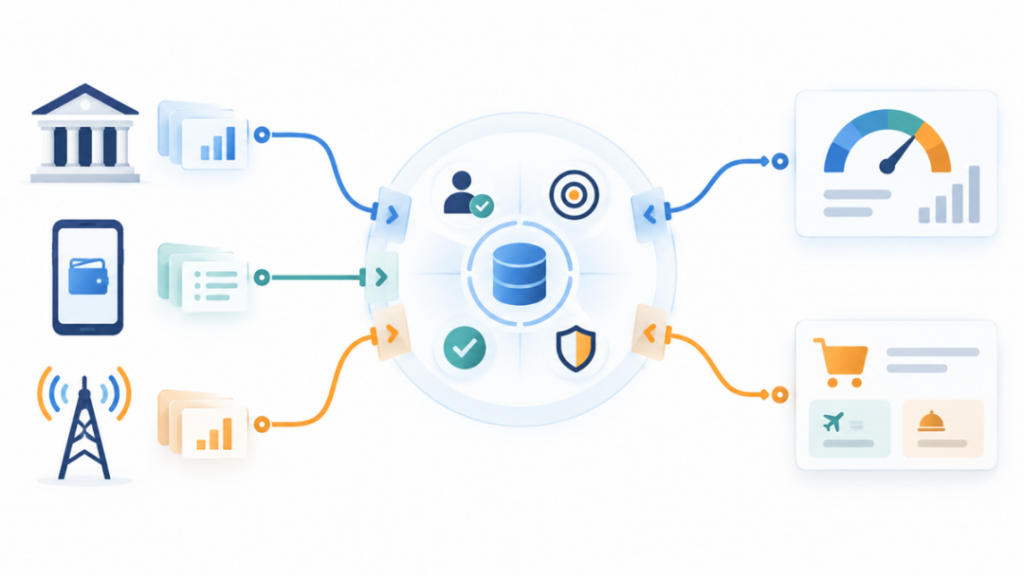
支付、电信等数据产生于不同的商业场景,掌握在不同机构手中。一家机构愿意提供一次研究样本,不等于金融机构能够长期、稳定地使用这些数据。即便模型在实验中表现良好,实际应用仍要解决数据取得、更新、质量核验、使用范围、责任承担以及各方合作的激励问题。
与此同时,个人信息保护要求也使这些问题更加突出。欧盟《通用数据保护条例》(GDPR)于2016年生效、2018年开始适用。其所体现的合法处理、目的限制和数据最小化等原则,促使各行业重新审视个人数据的利用方式。中国的征信业务本身也有个人信息采集、告知和同意等规则;不同之处在于,传统征信已经围绕相对明确的业务目的形成了较成熟的运行机制,而将原本产生于支付、电信等场景的数据用于信用评价,需要进一步厘清其处理依据和用途边界。
换句话说,大数据征信面临两个连续的问题:拿到数据之后,能否建立可靠的模型;在建模之前,能否建立让数据被合规、持续使用的机制——即大数据管理问题,如果让其更好地流通与应用。 后一个问题逐渐成为我研究的重点。
从征信应用,走向个人数据管理
从2018年起,我跟随原人民银行吴晓灵副行长开展个人信息保护相关课题,开始系统研究个人大数据的管理问题。我们关注过多种个人数据的商业模式,包括专业征信机构(SCRA)、数据经纪商(Data Broker)、开放银行和MyData。它们的出发点、参与主体及个人在其中的地位并不相同,但都试图回答同一组实际问题:数据如何在不同机构之间流动?谁能决定用途?个人如何参与?谁对数据质量和使用后果负责?
最初,我研究这些模式,是为了找到支付、电信等数据服务信用评价的可行路径。特别是在2019年开始深入研究MyData之后发现,征信只是其中一个应用场景。一个人产生的数据分布在金融、通信、消费等机构;这些数据要进入新的服务场景,都会遇到相似的难题。个人数据管理因此不再只是征信建模的前置环节,而成为一个需要独立研究的制度与产业问题。
这也让我重新认识传统征信的价值。征信的经验不仅在于信用评分,更在于它经过长期实践,形成了数据报送、主体准入、用途管理、质量控制、异议纠错和责任分配等机制。这些经验可以为今天讨论可信数据空间和数据要素流通提供参考。当然,其他场景的数据性质、使用目的和参与者关系不同,不能把征信规则直接照搬过去。
数据流通,需要能长期运行的机制
回顾这条研究路径,我的关注点经历了三个层次:先是如何利用新数据(大数据)建模,继而是如何管理和取得新数据(大数据),最后是如何让个人数据在不同场景中可信、持续地流通和应用。
对今天的数据要素市场而言,值得追问的不只是“有什么数据”“建设什么平台”,还包括:谁有动力提供数据?使用者能否获得质量稳定的数据?个人的权益如何得到保障?数据发生错误或造成损害时,谁负责纠正和承担责任?
如果这些问题没有答案,再先进的模型也可能停留在试验阶段,再大的数据平台也难以形成持续的应用。反过来,如果能够从具体业务问题出发,建立清楚的用途、责任和激励机制,个人数据才可能在保护权益的前提下,真正服务于信用评价以及更广泛的消费场景。
从大数据征信走向个人数据治理,对我而言,是同一个问题的不断深入:怎样让有价值的数据,以可信、可持续的方式发挥作用。
这个问题在AI变革时代,还在继续延续!